免费服务器 + 免费模型,能跑多快?
三值权重与四比特量化大语言模型在 ARM CPU 上的实际表现
Ternary vs 4-bit Quantised LLMs on ARM CPUs: A Practical Performance Study
标题说明
实验时间:2026 年 11 月。 模型、推理引擎和免费额度每隔几个月就会变化,文中的数字只代表这个时间点。我这台服务器是早期申请的(4 核、24 GB),现在的免费额度少了一半,但一样可以申请来用。
标题有点「标题党」,不过内容是认真的。「免费的服务器」指 Oracle Cloud Always Free 免费计划里的 ARM 云服务器;「免费的模型」指可以下载到本地运行的开源模型,不用按 token 给前沿大模型的 API 付钱。
本文实测了三值权重模型和 4-bit 量化模型在普通 CPU 服务器上的运行速度,用的正是一台免费额度里的 ARM 服务器。同学们手上如果有一台普通电脑或者免费服务器,也可以照着本文的方法自己测一测。
一台免费的 ARM 服务器,能不能跑大模型?
很多人都申请过 Oracle Cloud 的 Always Free 免费计划。其中最受欢迎的,是基于 Ampere ARM 处理器的 VM.Standard.A1.Flex 云服务器。早期的免费额度最多可以开到 4 核、24 GB 内存;现在 Oracle 官方文档写的是每月 1,500 OCPU 小时和 9,000 GB 小时,相当于 2 核、12 GB 内存1。这台机器没有 GPU。很多人用它建网站、跑论坛、做各种小实验。
那么一个很自然的问题是:这样一台没有 GPU 的机器,能不能跑大语言模型?我之前在同类服务器上试过 Google 的 Gemma,简单问答都很慢。不过当时用的具体型号和量化方式已经记不清了,只能算个印象。
这两年情况变化很快。这背后其实有两个方向相反的趋势。一边是训练最顶级的大模型越来越贵,只有少数大公司玩得起;另一边是跑一个「够用」的模型越来越便宜:同等能力的模型,推理成本这两年下降了上百倍2。小模型、蒸馏、量化和推理引擎的优化,一起把大模型从数据中心带到了普通电脑上。本文要测的,就是第二个趋势走到了哪一步。
在这条路上,还有一条特别的路线:三值权重(ternary weights) 模型。它的权重只取 -1、0、+1 三个值(注意,这不是「三进制」计算)。不少人认为三值模型的效率更高。
这几年三值权重非常热,软件和硬件两边都有人在做。本文测的 Bonsai 模型来自 PrismML,他们现在已经推出了新一代的 Bonsai 2,这次测的是更早的版本。我的朋友们也在这个方向创业:T3ISC 做三值芯片,让芯片本身用三种状态来计算,这倒是真正意义上的「三进制」硬件;ternii 把很小的三值模型放进手机,完全离线运行,数据不离开设备。
所以我决定亲自试一试:在一台没有 GPU 的 ARM 云服务器上,三值权重模型和常见的 4-bit 量化模型,到底能跑多快? 三值模型的文件更小,那它是不是也更快?
先说结论
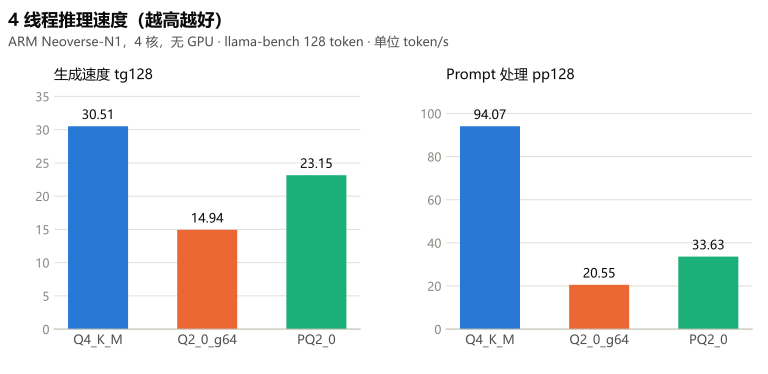
我在这台 4 核 ARM 服务器上比较了一个常见的 4-bit 模型(Qwen3,Q4_K_M 格式)和三值模型 Bonsai 的两种格式。两个都是十几亿参数的小模型。
- Qwen3 4-bit:每秒生成约 30.5 个 token,三个里面最快。
- Bonsai,通用三值格式
Q2_0_g64:约 14.9 个 token。 - Bonsai,PrismML 专用格式
PQ2_0:约 23.2 个 token,比通用格式快了一半多,但还是没追上 4-bit。
三值模型的文件只有 4-bit 模型的三分之一左右,可速度并没有因此更快。位数少了,存储省了,但速度还要看计算的代码写得好不好。
我也试了微软的 BitNet,可惜在这台 ARM 机器上一跑就崩溃,没有拿到数据,后面单独说。
结果一览
先看四线程下的速度。4-bit 的 Qwen3 生成最快;Bonsai 换成专用的 PQ2_0 格式后,比通用的 Q2_0_g64 快了约 55%,但还是比 Q4 慢。
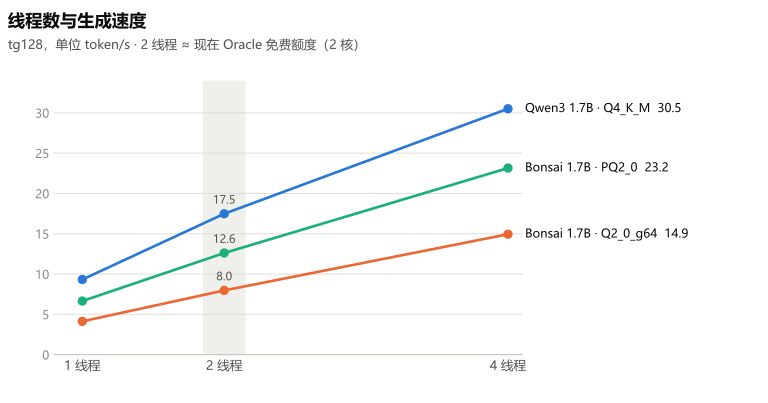
再看线程数。三个组合的速度都随线程数稳步增长。如果你用的是现在的免费额度(2 核),可以看中间那一列:Q4 每秒大约生成 17 个 token,单人使用的轻量文本任务已经值得一试。
最后这张图是本文最想说的一点:三值模型的文件小得多,但速度并没有因此更快。
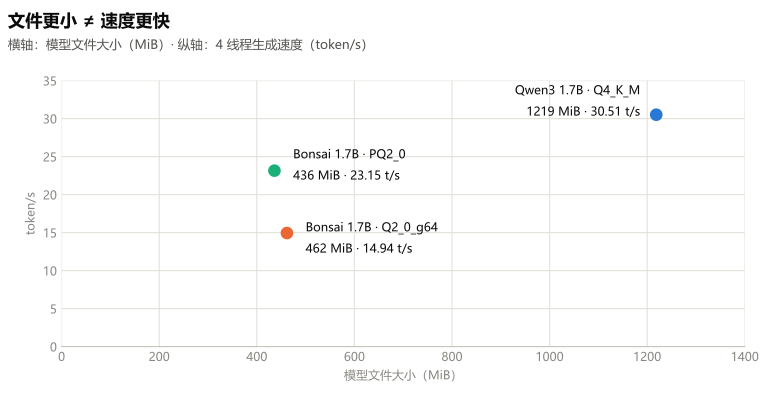
完整数据(单位 token/s):
| 模型和格式 | 文件大小 | 生成速度 1 / 2 / 4 线程 |
Prompt 处理 4 线程 |
|---|---|---|---|
Qwen3 · Q4_K_M |
1.19 GiB | 9.3 / 17.5 / 30.5 | 94.1 |
Bonsai · Q2_0_g64 |
462 MiB | 4.1 / 8.0 / 14.9 | 20.6 |
Bonsai · PQ2_0 |
436 MiB | 6.7 / 12.6 / 23.2 | 33.6 |
Q2_0_g64 我在两个推理引擎上都跑过(原版 llama.cpp 和 PrismML 的版本),结果几乎一样,表里用的是 PrismML 的数字。
几个概念,简单说清楚
4-bit 量化(Q4)。 大模型的权重原本用 16 位浮点数存储。量化就是把它压到更少的位数,比如 4 位,文件变小,内存也省了。本文用的 Q4_K_M 是 llama.cpp 里很常用的一种 4-bit 格式。
三值权重。 每个权重只有三种可能:-1、0、+1(再乘一个缩放系数)。三种状态在理论上只需要 log₂3 ≈ 1.58 位来表示,所以这类模型常被叫作「1.58-bit 模型」。不过实际文件一般按 2 位一组打包,再加一些额外信息,所以文件不会真的小到 1.58 位。
GGUF、llama.cpp 和推理内核。 GGUF 是一种模型文件格式,llama.cpp 是读取它、在本地运行模型的程序。真正决定速度的,是 llama.cpp 里做矩阵乘法的那部分底层代码,一般叫「推理内核」(kernel)。同样是三值模型,权重怎么打包、内核怎么写,速度可以差很多。
Bonsai 的两种格式。 Q2_0_g64 是原版 llama.cpp 就能读的通用格式;PQ2_0 是 PrismML 自己设计的打包格式,需要用他们改过的 llama.cpp 版本来跑。两个文件来自同一个模型,只是打包方式和计算代码不同。
小插曲:一个晚上写出来的 llama.cpp
llama.cpp 的作者是 Georgi Gerganov。2022 年 OpenAI 发布了语音识别模型 Whisper,他用纯 C/C++ 写了 whisper.cpp,不依赖任何深度学习框架,普通电脑就能跑。为此他顺手写了一个小小的张量库,叫 ggml。
2023 年 3 月,Meta 的 LLaMA 模型出来没多久,他就用 ggml 写出了 llama.cpp。第一版 README(2023-03-10)写得很直白:目标是「在 MacBook 上用 4-bit 量化跑这个模型」,Apple silicon 是「first-class citizen」。还有一句很坦诚的话:
This was hacked in an evening - I have no idea if it works correctly.
当时为苹果芯片写的 ARM NEON 优化,后来也让所有 ARM 处理器受益,包括本文这台 Oracle 的服务器。今天的 llama.cpp 支持 NVIDIA、AMD、Intel、高通骁龙、摩尔线程的 GPU,甚至 IBM 大型机;GGUF 也成了本地模型最常用的文件格式之一。本文用到的三个推理引擎,两个直接基于 llama.cpp,微软的 BitNet 也把它作为子模块。一个晚上开始的开源项目,撑起了今天大半个本地大模型生态,这份功劳不应该被忘记。
我是怎么测的
机器。 Oracle VM.Standard.A1.Flex,Ampere Altra 处理器(ARM Neoverse-N1 核心),4 核,24 GB 内存,Ubuntu 22.04,没有 GPU。这个处理器支持 ARM 的 NEON 和 dotprod 向量指令,但没有更新的 SVE、i8mm 这些指令。
软件。 原版 llama.cpp、PrismML 改过的 llama.cpp,还有微软的 BitNet。这几个项目更新很快,下面是这次用的版本,想复现的读者可以下载完全相同的代码:
| 项目 | 版本(Git commit) |
|---|---|
| llama.cpp | 9f0e5098a |
| PrismML 的 llama.cpp | 6447906bf |
| Microsoft BitNet | 0b341e5 |
先打个招呼。 测速度之前,我先问每个模型一句:「请用一句话解释 DNS 的作用。」Qwen3 一开始让我有点意外:我只给了它 50 个 token 的额度,结果它全用在「思考」上了,还没开口回答就用完了。放宽到 512 个 token 以后,它答得很准确。Bonsai 则直接给出了正确的一句话答案。
再测速度。 用 llama.cpp 自带的测速工具 llama-bench,每个组合分别用 1、2、4 个线程,各跑 3 次取平均:
./build/bin/llama-bench -m <模型文件> -t 4 -p 128 -n 128 -r 3
它会报两个数字:
- Prompt 处理速度:模型「读」你的输入有多快。
- 生成速度:模型「写」回答有多快。聊天时你感受到的主要是这个。
为什么文件更小,却不一定更快?
直觉上,文件越小,要从内存里搬的数据越少,应该越快。但在 CPU 上,速度还取决于另外几件事:
- 解包的开销。 三值权重是紧紧打包存放的,计算前要先拆开、转换成 CPU 能直接计算的形式。这一步省不掉,可能把省下的内存带宽又吃回去。
- 计算代码写得好不好。 4-bit 格式在 llama.cpp 里已经被优化了很久。三值格式还比较新,代码成熟度不一样。Bonsai 换成 PrismML 专门写的格式和代码,就快了 55%,说明这一块的空间还很大。
- CPU 指令。 这台服务器的处理器没有专门为低位数计算设计的新指令,三值模型的优势不一定发挥得出来。
所以要看你追求什么:如果是最小的下载文件、最省内存,三值模型已经有明显优势;如果是单次对话最快的响应,在这台机器上目前还是 4-bit 领先。
BitNet 为什么没跑起来
微软的 BitNet b1.58 是最有名的三值模型之一。我在这台服务器上编译成功了,但不管用 1 个线程还是 4 个线程,模型都在生成第一个字之前崩溃,报的是一个数值检查失败(Assertion scale > 0.0f failed)。这通常说明前面某一步计算已经算出了无穷大或者无效的数。
我翻了一下源码,发现一个可疑的地方:同一种三值格式,代码在 x86 处理器上按 128 个权重一组来解码,在 ARM 上却按 64 个一组。GitHub 上也有好几位开发者报告了 ARM 上的类似问题(#585、#598、#600),还有人提交了修复方案(PR #551),到我写这篇文章时都还没有解决。不过他们看到的主要是输出乱码,我这边是直接崩溃,是不是同一个原因还不能确定。
所以这次 BitNet 没有放进比较。这不说明 BitNet 本身不行,只说明它在 ARM 上的代码还有问题。我打算以后深入它的代码,看看能不能修好,到时候再单独写一篇。
想自己深挖的读者,可以从这几个 GitHub 讨论看起(状态截至 2026-11-08,都还没有关闭):
- Issue #585:ARM 上的 I2_S 解码按 64 个权重一组,而模型文件是按 128 个一组打包的,导致输出乱码。这一条讲得最清楚,还给出了逐个算子的对照。
- Issue #598:AArch64 上 I2_S 输出错误,指出了分组大小、解包和部分矩阵乘法代码的问题。
- Issue #600:和我用的是同一个版本(
0b341e5),在 ARM/NEON 上输出乱码;修好一处解包以后,可能还有别的问题。 - PR #551:社区提交的 ARM 修复方案,还没有被合并。
需要注意的地方
这只是一次小规模的测试:Qwen3 和 Bonsai 是两个不同的模型,所用的推理引擎版本也不完全相同,所以这不是严格意义上「4-bit 对三值」的对照实验。我只测了速度,没有测回答质量、首字延迟、内存峰值和耗电,也只用了很短的 128 个 token 的输入和输出。这些数字适合用来大致判断「能不能用」,不适合下「三值模型不行」这种结论。
写在最后
回到标题的问题:免费服务器 + 免费模型,能跑多快? 在 4 核的 ARM 服务器上,一个十几亿参数的 4-bit 模型每秒能生成 30 个左右的 token;用现在免费额度的 2 核,大约是 17 个。这个速度已经比人的阅读速度快,做一些轻量的文本处理是可以考虑的。
三值模型这次没赢,但我并不悲观。专用格式一下子就快了一半多,说明它的代码还有很多可以挖的地方。如果再配上为三值计算设计的芯片,结果可能完全不一样。
接下来我想做几件事:把 BitNet 修好再测一次;找一个实际的任务,比如文章的拼写和语法检查,看看这些小模型的质量够不够用;再看看三值模型到底慢在哪一段代码上。
同学们如果手上有一台免费服务器,或者一台普通电脑,不妨照着上面的命令跑一跑,看看你的机器能跑多快。
参考链接
- llama.cpp、ggml、whisper.cpp
- Qwen3 1.7B GGUF:本文用的 4-bit 模型
- PrismML 和 Ternary Bonsai 1.7B GGUF:本文用的三值模型
- Microsoft BitNet 和 BitNet b1.58 2B4T GGUF
- T3ISC(三值芯片)、ternii(手机上的三值模型)
-
Oracle Cloud Infrastructure 文档:Always Free Resources(2026-11-08 查阅)。 ↩
-
Stanford HAI, AI Index Report 2025:达到 GPT-3.5 水平(MMLU 64.8%)的模型,推理价格从 2022 年 11 月每百万 token 约 20 美元降到 2024 年 10 月约 0.07 美元,约下降 280 倍。 ↩